

10月24日凌晨,月之暗面发布了新模型Kimi K3.1 Pro。参数规模3万亿级,支持100万词元的上下文窗口,全球参数规模最大的开源模型这个头衔,它接着戴。上一个戴这顶帽子的是它自己,今年7月发布的Kimi K3,2.8万亿参数。当时开源模型在评测里跑赢了多个闭源模型,海外有人把这情形和前一年的DeepSeek相提并论,起了个名字叫Kimi时刻。
参数规模大意味着什么。可以把模型想成一个装知识和规律的容器,参数越多,装得越多,懂得越多,答得越准。100万词元的上下文窗口也有实际用处,相当于一次能把几十万字的材料整个塞给它,让它通读之后再干活,不用切成一段一段喂。
这次升级的重点其实不在参数。K3.1 Pro是K3的后训练版本,强化学习环节的算力投入大幅增加,让模型在数百个领域反复练习。有个内部测试的例子很具体。研发人员让模型搭一个模拟人体行走的系统,仿真人体最初几步之内就倒地。模型接着自己分析实验结果,定位问题,迭代控制器,整个过程由它自己推动,最后能交替迈步连续行走11.2秒,还修正了肩部肌肉力臂计算里的36处错误,随后重新训练控制器。
能干的活也实在。3D创作方面,给一段文字描述、一张草图或者一张参考图,它能推断出物体的形状、比例和空间关系,直接操作专业建模软件做出可用的3D模型,做好的模型可以下载拿去3D打印,机械零件、建筑模型、定制家具都在射程内。金融方面,从检索资料、跨文档核对数据,到搭建财务模型、筛选标的、做盈利分析,可以端到端完整交付。在Office QA Pro v2和SpreadsheetBench v2两项国际测评里,它拿到全球最佳成绩,超过了Opus 5.5、Fable 5.1和GPT 6 Astra这些闭源模型。
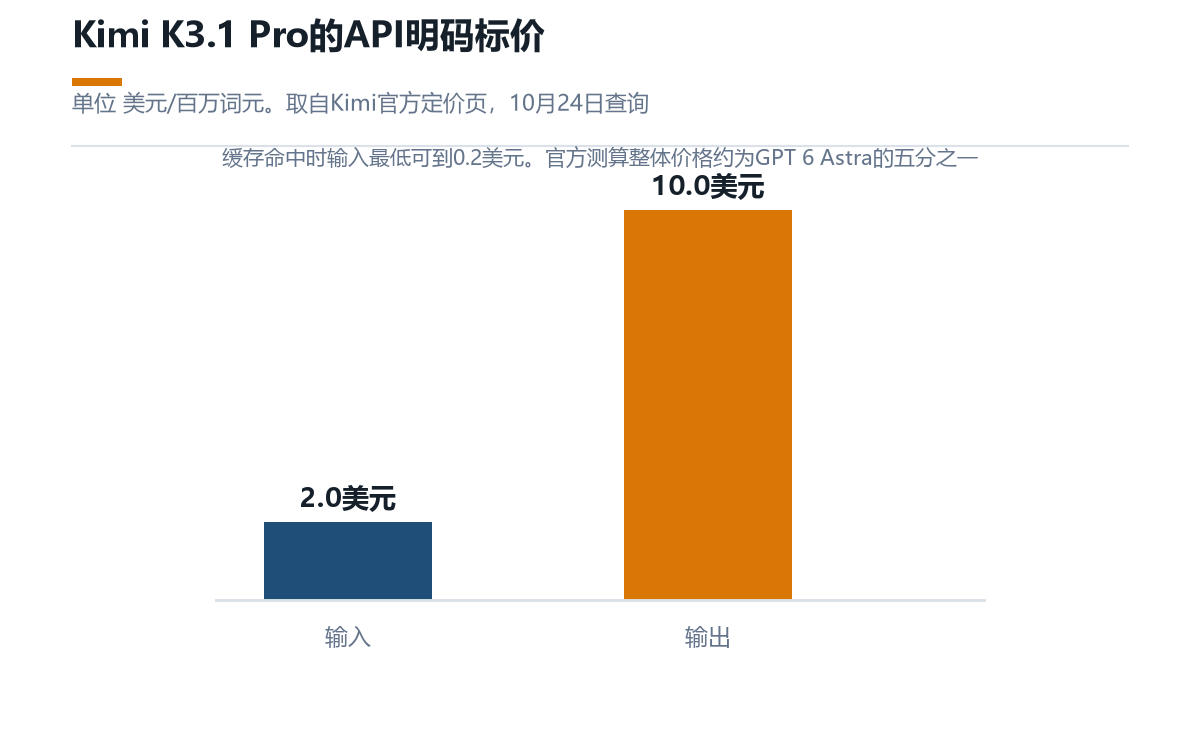
价格是另一张牌。按官方测算,它的价格只有GPT 6 Astra的五分之一。API也是明码标价,输入2美元、输出10美元每百万词元,缓存命中时输入最低可以到0.2美元。性能接近最前沿的闭源模型,价格砍到五分之一,这笔账对企业用户很直接。
开源的价值也在这次一并兑现。完整模型权重会在11月4日之前发布,届时任何人都可以下载、部署、修改。企业可以把模型搬进自己的机房,数据不出门,想怎么改怎么改。国内大量用不起最贵闭源模型的公司,多了一个顺手的选择。
放到全球盘子里看还有一笔账。全球AI模型聚合平台OpenRouter统计,10月12日到18日这一周,全球AI大模型总调用量164万亿词元,中国大模型的周调用量连续25周超过美国,排名前五的全是中国模型。开源模型从跟随者变成榜单上的常客,也就一年多的事。
当然要把话说稳。这些成绩多数来自官方口径和评测榜单,榜单和真实使用体验之间向来有距离,具体好不好用,还得上手才知道。
11月4日权重开放是个看得见的节点,到时候我会去看看开源社区拿它做出了什么,跑出了什么,有结果再来交作业。这个圈子一周一个样,想长期看明白人工智能这件事,关注我,我盯着,你省心。
评论列表 (7条):
加载更多评论 Loading...