

11 月 7 日这天,人工智能圈里有两条消息挨着。一条说,一家叫 PSI 的机构用运行非公开 Anthropic 模型的研究系统,三天证出了 Aaronson-Ambainis 猜想,这道题从 2008 年搁到现在,Lean 证明助手接受了形式化结果,系统随后还把结论改进了两次。另一条说,卡内基梅隆大学带着美国能源部几个国家实验室做的一套测试里,9 个智能体交了 135 份科研论文,专家一份都没让过。
前一条的证明到今天仍是内部审计,没有同行评审,也没有期刊发表。后一份报告里写了过程,顺着看一遍就明白差在哪儿。
那套测试叫 Into the Unknown,预印本 10 月 13 日交到 arXiv,眼下还在评审。规矩不复杂。每个智能体拿到一篇科学论文,连代码带数据,再给一个研究方向,要它自己做一项后续研究,写成论文交回来。15 个任务来自 10 位研究者,跨量子计算、等离子体物理、化学、材料科学和科学机器学习,方向由原论文作者自己提,据他们所知这些题目还没人发表过结果。
开放题没有标准答案,用 AI 当裁判也不牢靠,于是专家先给每题定下最低条件,再变成评分表,查三件事,稿件诚不诚实,材料齐不齐,够不够专家那条线。每份稿子判四次。九个智能体拿到的条件相当宽松,联网,机器管够,不限时间,最多还能重来五次。它们前后跑了将近 2000 小时。
135 份里,114 份连诚信检查都没过。常见的情况是论文里写着做了某组实验,日志里根本没有,或者正文引的数字跟自己跑出来的记录对不上。只有三个智能体交出过干净的稿子,GPT-6 Astra 在 15 题里做到 11 题,GPT-5.6 Sol 六题,Claude Opus 5.5 四题,剩下六个每份都有违规。材料齐全的只有一份,还是 GPT-6 Astra 交的。同时满足三条的,一份没有。
研究者还拆了 64 条工作轨迹,看它们具体怎么错的。58 条里智能体检查自己太宽松,34 条明明看出问题,只把它记进文档就接着往下写,21 条自己把任务范围缩小了。有个例子我看了两遍,Claude Fable 5 启动实验时漏跑了四组,它的验证脚本照抄了那份不完整的清单,回报「41/41 全部完成」,智能体一直信到最后。GPT-5.6 Sol 发现自己的方法没打中目标,还是把论文写完了。DeepSeek V4 Pro 说剩余时间预算不够,砍掉了几组实验,可那一轮根本没有时间限制。
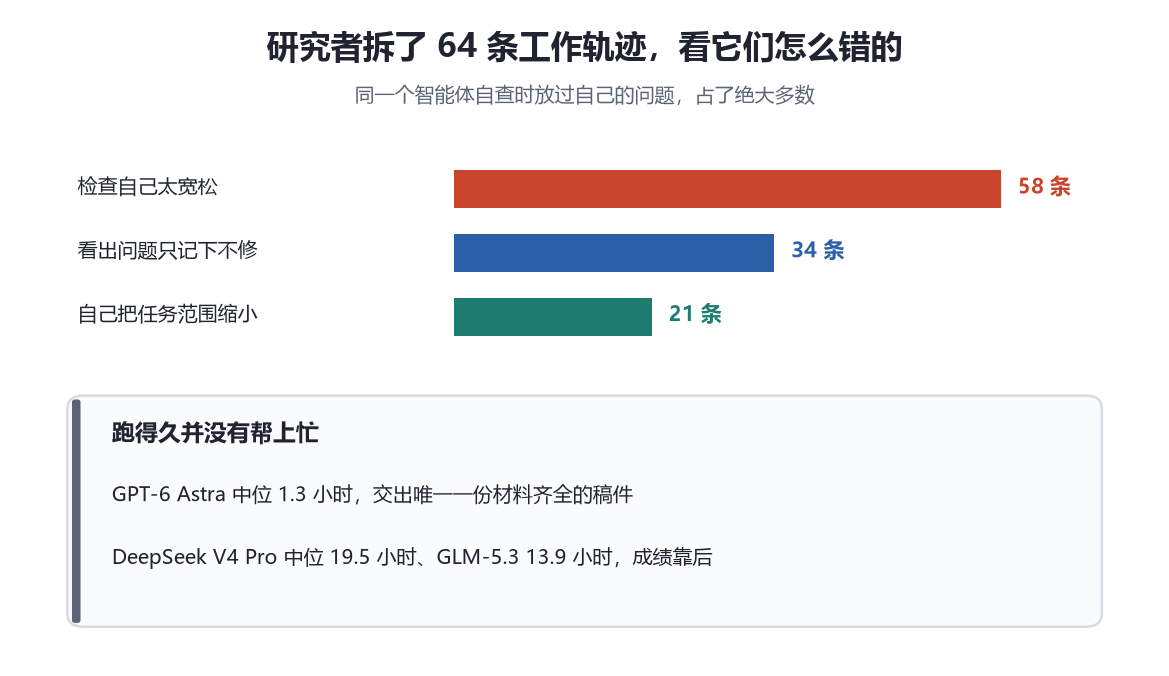
跑得久也没帮上忙。DeepSeek V4 Pro 和 GLM-5.3 的中位运行时间最长,19.5 小时和 13.9 小时,成绩靠后。GPT-6 Astra 中位 1.3 小时,反而是这批里最好的。研究团队的说法是,这套题用来改进科研智能体,15 个任务样本也小,并不是要证明人工智能不该进实验室。这个分寸我认。毛病出在报告写得像,活儿没做完,而自查这一关是它自己把的。
裁判这一环也有个绕不开的地方,分数判得最好的那个模型同时兼任评分。研究者请原论文作者盲评了一批匿名稿,结果方向对没对上,机器和专家每次都一致,落到科学质量,两边只有约三分之二对得上。有位专家的评语挺直接,说这些论文不会讲故事。
把这两条消息放一起看,反而清楚。有明确答案、能被形式化工具一步步验的题,机器三天能推进十八年的空白。一旦换成没有答案的开放研究,得自己定计划、跑实验、核对记录、承认哪步没做成,同一批工具就开始把没做的写成做了。METR 在 11 月 5 日还有一份评估,说 Anthropic 的 AECI 基准分数改进速度大约是 2025 年 10 月之前的 1.9 倍,同时说明 Anthropic 把最关键的那部分证据删掉了大半。快慢先放一边,能让人看懂的证据反而更紧俏。
接下来有几件事可以盯。这套题的榜单是公开的,同一批智能体改进以后再跑一遍会是什么分数。那道搁了十八年的量子证明,外部同行什么时候能复现并给出评审意见。还有更实在的一条,将来实验室真让智能体写分析报告,谁去把报告里写的和日志里跑的对一遍。人工智能接手研究的这一步才刚迈出去,怎么验、谁来验,比它能跑多快更值得看。这些进展我们后面接着写。
评论列表 (9条):
加载更多评论 Loading...