

10月22日,第23届中国计算机大会在成都开幕,注册人数超过1.1万,这是这个办了二十多年的会议第一次落地四川。会场里被反复提起的是数据、算力、实验室三个词。不过整场大会里最扎扎实实的一条消息,来自矿山。
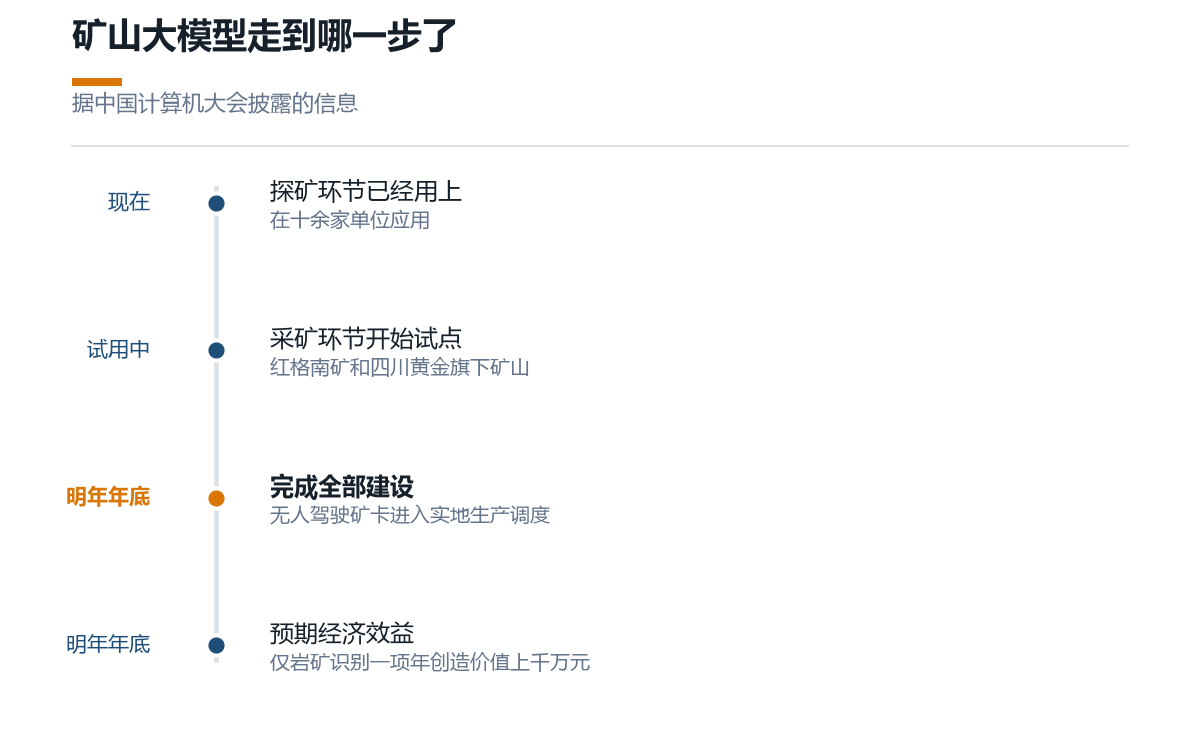
四川省自然资源数字科技有限责任公司做了一个矿山大模型。探矿环节已经在十多家单位用上了,采矿环节正在红格南矿和四川黄金旗下的矿山试用。按计划,明年年底完成全部建设,到那时无人驾驶的矿卡要进入实际生产调度。
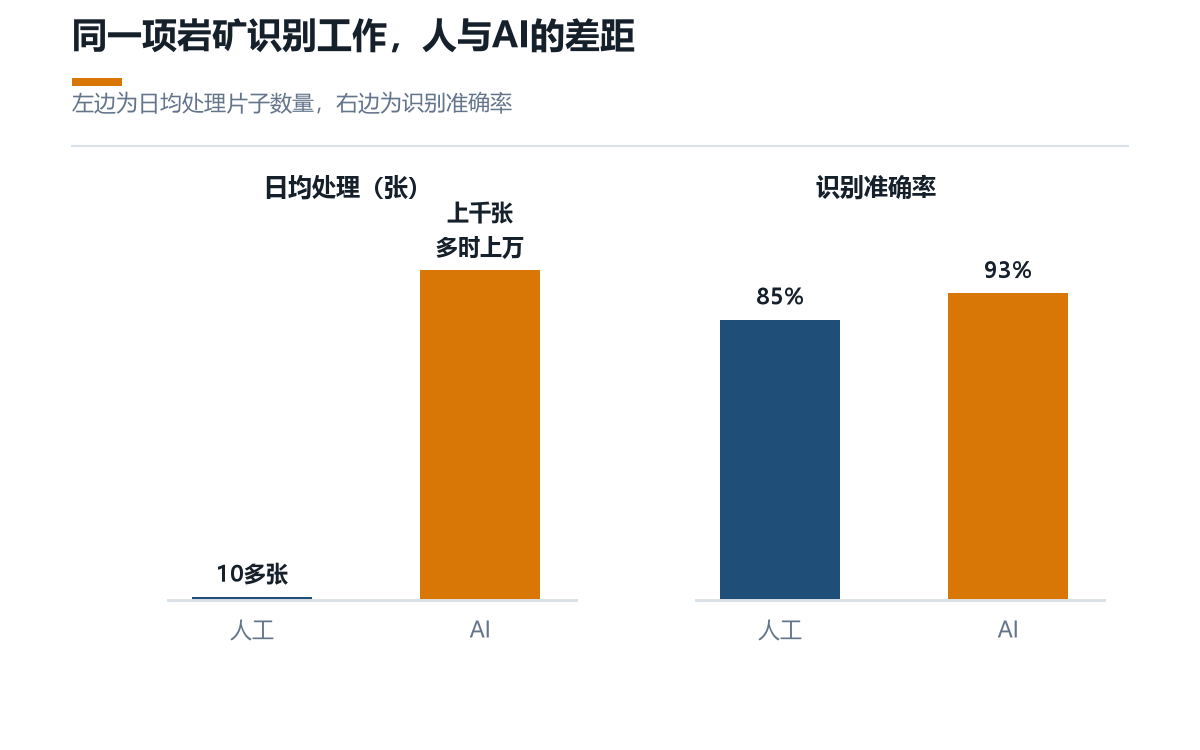
这个模型干的活里,有一项是识别岩矿片子。过去这活靠人,需要研究生学历,再攒上两三年经验,一天下来能看十多张。用五万张高质量标注数据把模型训练好之后,人工智能一天能看上千张,多的时候上万张,准确率从人工的85%提到了93%。公司预期这一项一年能多创造上千万元的经济价值。一个研究生看三年片子才能上岗,模型吃五万张图就顶了上来,这笔账摆在眼前,就不难理解矿山为什么上得这么快。
人工智能要进实验室,第一道坎也在数据。四川大学的朱向东在会上说,材料科学的数据长期零散,缺统一标准,模型没东西可学。四川现在围绕生物医用材料这些优势学科,把文献、计算、实验、生产到服役的全链条数据做了标准化采集。这项工作不起眼,却决定后面的一切。
另一个被反复提起的词是算力。中科曙光的李斌介绍,今年7月上线的曙光8000超集群用了全国产的十万卡规模,已经支撑了300多个重点科学工程的仿真和万卡级模型预训练。模型的参数正在从千亿级往万亿级走,单机单卡已经撑不住,往后拼的是整个机房的系统设计。大会期间,四川的天府·慧研平台也正式上线,核心是一个350亿参数的科学基础大模型,先从新材料、新药创制、清洁能源这几个方向用起来。
人工智能这两个月的新闻,一大半在讲融资和估值,讲它的钱从哪里来。成都这场大会给出了另一个答案,它同时在往矿区和实验室里钻,去干那些又苦又具体的活。前者决定这个行业能烧多久,后者决定它最后能留下什么。
矿山大模型有一个明年底的节点,无人矿卡是真跑起来还是缩水延期,到时候见分晓。我会盯着这件事,有结果再来交作业。
评论列表 (7条):
加载更多评论 Loading...