

10月27日,谷歌DeepMind发布了新一代世界模型Genie 4的研究预览版,官方的说法是迄今最逼真、最具交互性的一个。它和常见的视频生成工具是两类东西。视频模型给你一段放完就结束的片子,世界模型给你一个能待在里面的环境,用键盘就能走动、调镜头,中途还能打字下指令,改天气、加一个人、放一个新物体进去,模型会接着往下推演。
这一代最明显的变化是声音。画面里的湖面有风声,吹萨克斯的人有琴声,角色能就着正在发生的事开口对话,全部由模型在生成每一帧的同时同步做出来,不需要后期配音。场景能连贯维持约2分钟,是上一代Genie 3的两倍。物理表现也有进步,空气阻力、碰撞这些交互更接近真实。谷歌把Gemini接了进来,让它在旁边当导演,追踪画面、拆解目标、验证动作,你随时喊停改戏,它负责让世界接得上。
短板谷歌自己也写了。模拟时间一长,细节和物体会漂移,你转身再回来,桌上那个杯子可能就变了样。复杂物理交互和空间精度,仍然是没解决的研究问题。
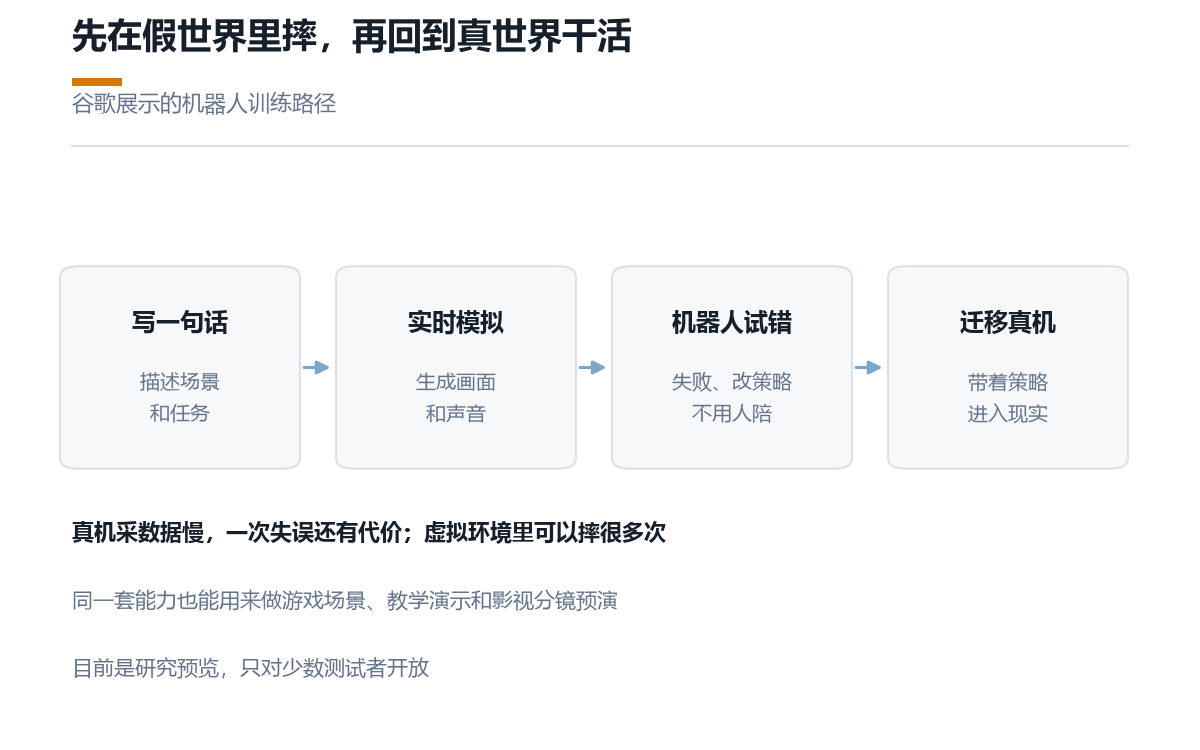
目前它只对少数受信任的测试者开放,几周内会扩大到谷歌AI Ultra订阅用户和API早期伙伴。对普通人来说,真正的看点在用途。谷歌展示了机器人训练的路径,让一个模型把任务拆成步骤,再由Genie 4实时模拟出来,机器人先在虚拟世界里试错,摔很多次也不用赔,策略练熟了再搬回真机。真机采数据又慢又贵,一次失误还有代价,这条路径要是走通,机器人学新技能的速度会换一个量级。测试者还发现它适合做影视分镜预演,导演在构思阶段就能走进自己写的场景里转一圈。
能造出足够真实的世界,也意味着能造出现实里不存在但看起来完全真实的画面,往后怎么分辨会越来越难。世界模型这条线刚从论文走向预览,我会持续跟,关注这个号,别错过它下一次开门。
评论列表 (8条):
加载更多评论 Loading...