

全球AI模型聚合平台OpenRouter统计,10月12日到18日这一周,全世界AI大模型的总调用量达到164万亿词元。调用榜的前五名,全是中国模型。中国模型的周调用量超过美国,这件事已经连续发生了25周。
词元是什么,可以再讲一遍。你跟AI说的每句话、它回的每个字,折算下来都按词元计量,词元调用量大致等于AI的实际工作量。这个数字比跑分更接近真实,跑分可以挑题目,调用量是用户真金白银的使用。
9月中旬还有过一个更直观的对比。OpenRouter的数据显示,9月7日到13日那一周,中国模型的调用量约61.2万亿词元,美国模型是21.8万亿,差距接近3倍。国内的报道标题当时就用了”DoorDash、Airbnb都在用”这个说法,海外公司的订单实打实流向了中国模型。
增长的速度值得单独看。今年6月中旬的一周,全球总调用量是44.6万亿词元,当时国产模型合计占比接近四成。9月上旬,这个数字到127万亿。10月中旬,164万亿。四个月翻了将近两倍,中国模型的占比还在往上走。更早的报道里还有个细节,海外的外卖平台DoorDash、民宿平台Airbnb,都在调用中国的模型。
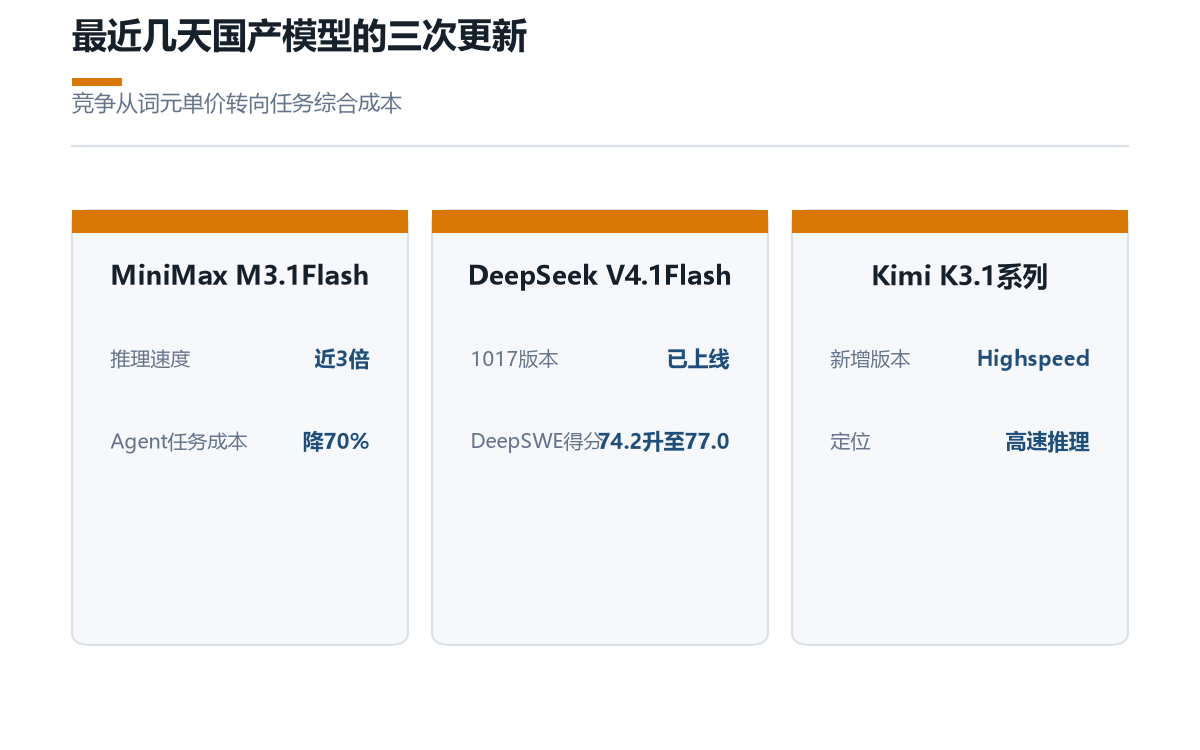
榜单背后是几家公司你追我赶的更新速度,最近几天的动作就有不少。MiniMax发布M3.1Flash,线上推理速度提到上一代的近3倍,Agent类任务的综合使用成本比上一代降70%。DeepSeek把V4.1Flash更新到1017版本,代码评测DeepSWE v1.1的得分从74.2提到77.0,同时开源模型权重,还推出自研的搜索API。Kimi在K3.1 Pro之外补了Highspeed高速版本。开源证券的研报注意到同一个趋势,大模型竞争的维度,已经从词元单价转向任务的综合成本和交付效率。
换个角度理解这件事。模型强不强,以前看评测榜单,现在多了个更实在的指标,全球的开发者和公司愿意把真活交给谁跑。词元是要花钱买的,一家公司长期用哪家的模型,这个选择比任何评测都有分量。中国模型连续25周在全球调用量上压过美国,买家认的理由,大概率还是便宜和够用。
也要把话说稳。调用量第一说明用得多,模型能力的最高上限,评测上领先的仍是少数几个闭源模型。用得多和能力顶是两回事,好在两条线都在往前走。
下一次OpenRouter周榜更新我会接着看。人工智能这个行当现在一周一个样,想长期看懂它走到了哪一步,关注我,我盯着,你省心。
评论列表 (7条):
加载更多评论 Loading...