

推特联合创始人杰克·多尔西旗下的公司Block,最近放出了一个叫Dessa的语音模型。训练数据只有人类对话的录音,没有文字,没有预训练模型。官方的说法是,据他们所知,这是第一个只用语音训练就能和人实时聊天的AI。
要理解这件事特别在哪,先看现在的语音助手怎么干活。它走三步,先把你的声音转成文字,文字交给大语言模型生成回答,再把回答合成语音放出来。Block认为毛病就出在转文字这一步,语气、停顿、情绪,这些文字装不下的东西全被扔掉了。他们在公告里写得挺直白,即便是全球最强的AI,也听不出你的情绪,这体验差,还可能有危险。
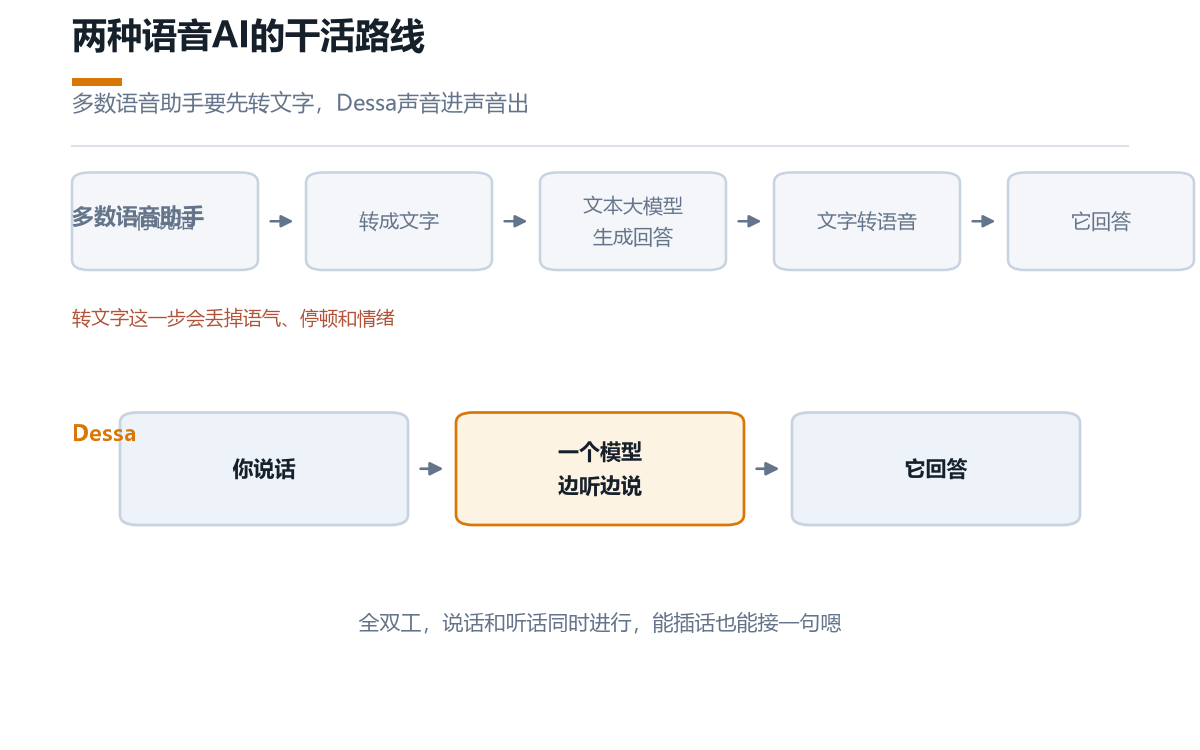
Dessa把三步并成了一步,声音进去,声音出来,中间不出现字。它还是全双工的,能一边听一边说。官方放出的录音里有这么几个瞬间。聊到好笑的地方,它会在句子中间笑出来,多数语音模型要等你讲完,再按时补一声笑。你让它大点声,它就提高音量。有人想不起一部电影的名字,它把后半句接了过去。听到对方说要带它去巴黎,它先倒吸一口气,小声来了句oh my god,再答话,官方形容那段听起来像哭了之后的道谢。
没有文字拐杖,学说话要难得多。官方给过几个数,同一个词,说出来的录音比写下来的字多占几千倍的数据量,语音还从不重复,同一句话录两遍,数据也不一样。即便这样,Dessa学会语言用的词量,比大语言模型少了几百倍,省下的力气花在了口音、停顿、呼吸和什么时候插话上。
成本有一条很扎眼。训练只用了一台英伟达GB200 NVL72。在这个动辄几千张卡一起上的年代,官方特意强调一台,等于在说语音数据的训练效率还大有空间。跑起来也轻,一台M4 Max芯片的MacBook Pro就能本地推理,速度比实时对话还快,语音不用上传云端。
团队来路也顺带交代一下。这是Block内部一个很小的研究组,成员来自多伦多一家2020年被Block收购的同名公司,做生成式语音八年,直接向多尔西汇报。负责人Ragavan Thurairatnam管这次发布叫语音的GPT-3时刻。
热闹之外得把另一面讲清楚。放出的样例是官方挑的,The Verge就注意到一段对话里,模型把说话的人错认成了Ronaldo。参数量、延迟数字、正式跑分,一样都没公布。现在它不对外开放,只给一小批AI安全研究者做测试,测试的重点就包括这类语音智能体怎么欺骗人类的风险场景。Block自己的说法是,一个只靠声音学会说话的模型是新领域,需要外面的人来找他们没预料到的风险。
语音这条路被文本模型压了两年,大家默认语音只是文字的外壳。Dessa反过来试了一次,把文字整个拿掉,至少证明了一件事,模型可以不读书就学会说话。至于能学到多少知识,各种场景下稳不稳,官方自己也把它列为待研究的问题,答案还没出来。
等外部测试的结果放出来,这类模型会不会出现在你手机里的语音助手上,值得盯着看。我会接着跟这件事,有新进展再来写。你要是也试过各家语音助手,评论区聊聊哪个最让你受不了。
评论列表 (9条):
加载更多评论 Loading...