

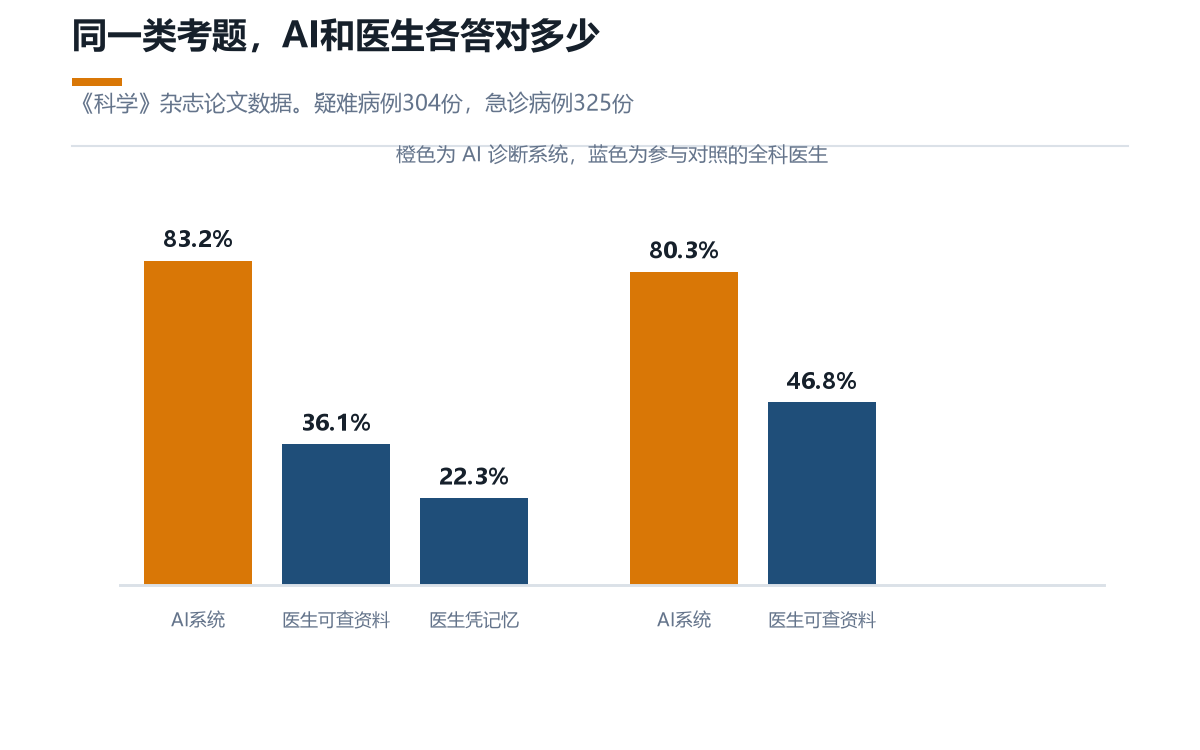
10月22日,《科学》杂志发了一篇微软的论文。他们做的医疗诊断系统叫MAI-DxO,在一组《新英格兰医学杂志》的疑难病例上答对了83.2%。同一个考场上,参与对照的全科医生平均只答对36.1%。
消息传开,不少标题写成了AI看病超过医生。数字是真的,几个关键条件也得一起看。
先看考试怎么出的。以前测医疗AI,多半是把症状、病史、检查结果一次给全,让模型从几个选项里挑一个,跟执业医师考试差不多。真实看病是另一回事,病人先说两分钟,医生自己决定问什么、查什么,一项结果回来,前面的判断可能推翻重来。
微软这次把考卷改成了这样。304个疑难病例,每个都只先给一小段介绍,考生接着决定问什么、开什么检查,每开一项检查都记一笔钱。答案评两样,一是诊断对不对,二是这一路检查花了多少。
系统内部像一个小会诊组。几个AI角色分工,有人提出可能的病名,有人专门挑最能区分这几种病的检查,有人负责唱反调,还有人盯着成本,拦掉又贵又没用的项目。一轮一轮讨论,证据到了再更新判断,最后交卷。
成绩分两组。疑难病例那组,系统83.2%,可以查教科书和上网的医生36.1%,全凭记忆的医生22.3%,全场最好的那位单个医生51.8%。换成更接近日常的急诊病例,系统80.3%,医生46.8%。
钱这一栏也值得看。系统放开手查的那档,平均每个病例的检查费约5431美元。收紧以后还有80.9%的准确率,费用约2241美元,不到对照组医生4725美元的一半。
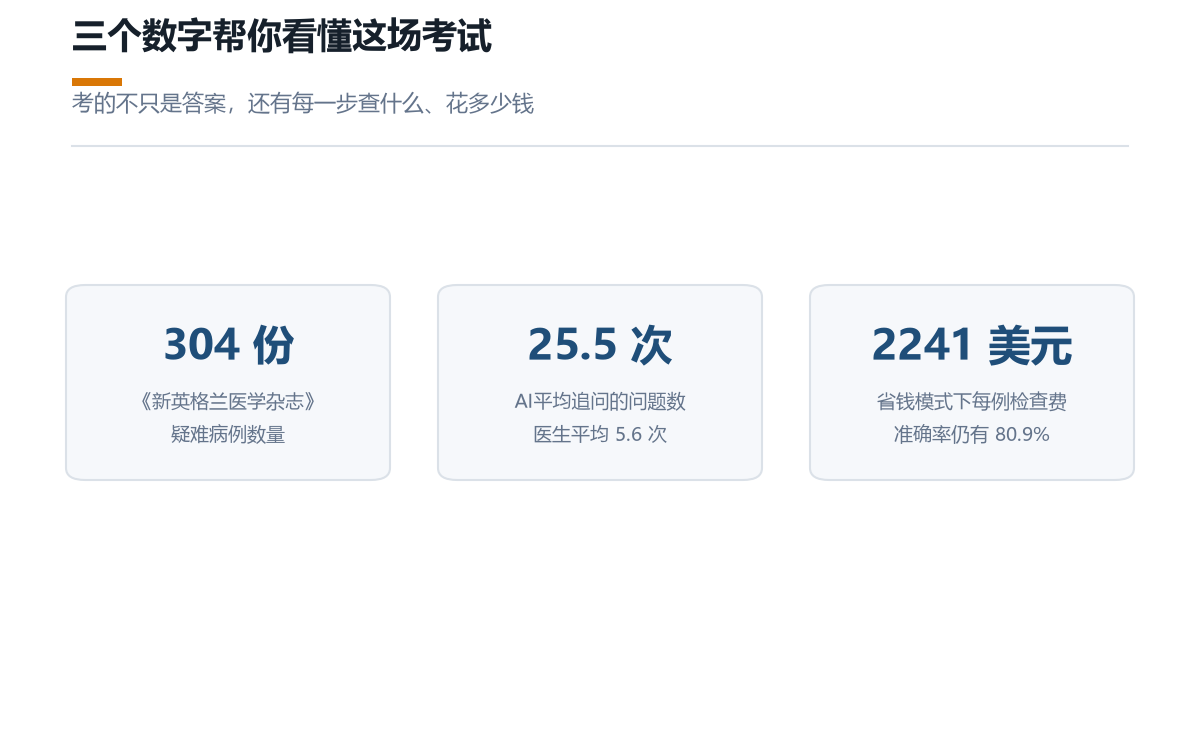
差距怎么来的,论文里有个细节。医生平均问5.6个问题就开出第一项检查,系统平均问25.5个。它把病史捋得慢得多,细得多。诊断质量很大一块,就落在问得细不细上。
先别急着下结论,这场考试有几个前提。比的是单独工作的全科医生,疑难病例在真实医院里通常交给专科医生或会诊团队,这批人没参加。病例都是已经写好答案的旧病历,对面没有会说不太清症状、过两天又改口的真实病人。判分标准也宽,处理方案一致就算对,诊断名稍有出入不扣分。
微软自己也清楚这一点。他们跟波士顿一家医疗中心谈好了下一步,做前瞻性研究,让真实患者直接跟系统交互,再跟医生的独立判断对比。还跟梅奥诊所合作训练医疗专用模型,预计明年发布。医院里的成绩单,要等那份研究交出来才算数。
对普通人来说,这事的用法现在就想得出来。症状拖了很久说不清,可以让AI帮你把时间线捋成几行。拿到体检报告满页名词,让它逐条翻成人话。胸痛、呼吸困难、大出血这种情况,别问任何AI,直接打120。它的位置是帮你把话说清楚,把文献翻得快一点,坐在你对面的还得是医生。
医疗AI往后几年会一路往前走,这类级别的研究以后不会少,每一次成绩更新都值得看一眼。点个关注,下次有大事,第一时间讲给你听。
评论列表 (8条):
加载更多评论 Loading...